
マルチテナントのDB設計:共有テーブル、スキーマ分離、専用DBとRLS
小笹佑京
小笹佑京
マルチテナントSaaSでは、テナント(SaaSを契約する顧客企業などの単位)のデータをどう配置すれば、あるテナントから別のテナントのデータが見えない状態を保てるのでしょうか。DB設計では、データを「どこに置くか」と「誰がどの行を読めるか」を分けて決めます。置き方は、共有テーブルにtenant_id列を持たせる、テナントごとにスキーマを分ける、データベースやインスタンスを分ける、の3方式に大きく分けられます。どれでも、あるテナントが別のテナントのデータに届く越境を防ぐ仕組みは別に要り、共有テーブルではPostgreSQLの行レベルセキュリティ(RLS)でDB側にも境界を置けます。
データの置き方は費用に関わりますが、安全性は置き方だけでは決まりません。データベースを分けていても接続先の選び方しだいで別テナントのデータにアクセスでき、RLSを有効にしていても、接続ロールやコネクションプールの扱いを誤れば、別テナントの行が見えます。そこで、この記事ではまずデータパーティショニングとテナント分離の違いを整理し、3つの配置方式を比較する観点を示します。そのうえで、RLSの実装例と適用条件、方式を選ぶ判断基準、後から方式を変える際の準備を説明します。
データパーティショニングとテナント分離はどう違うか
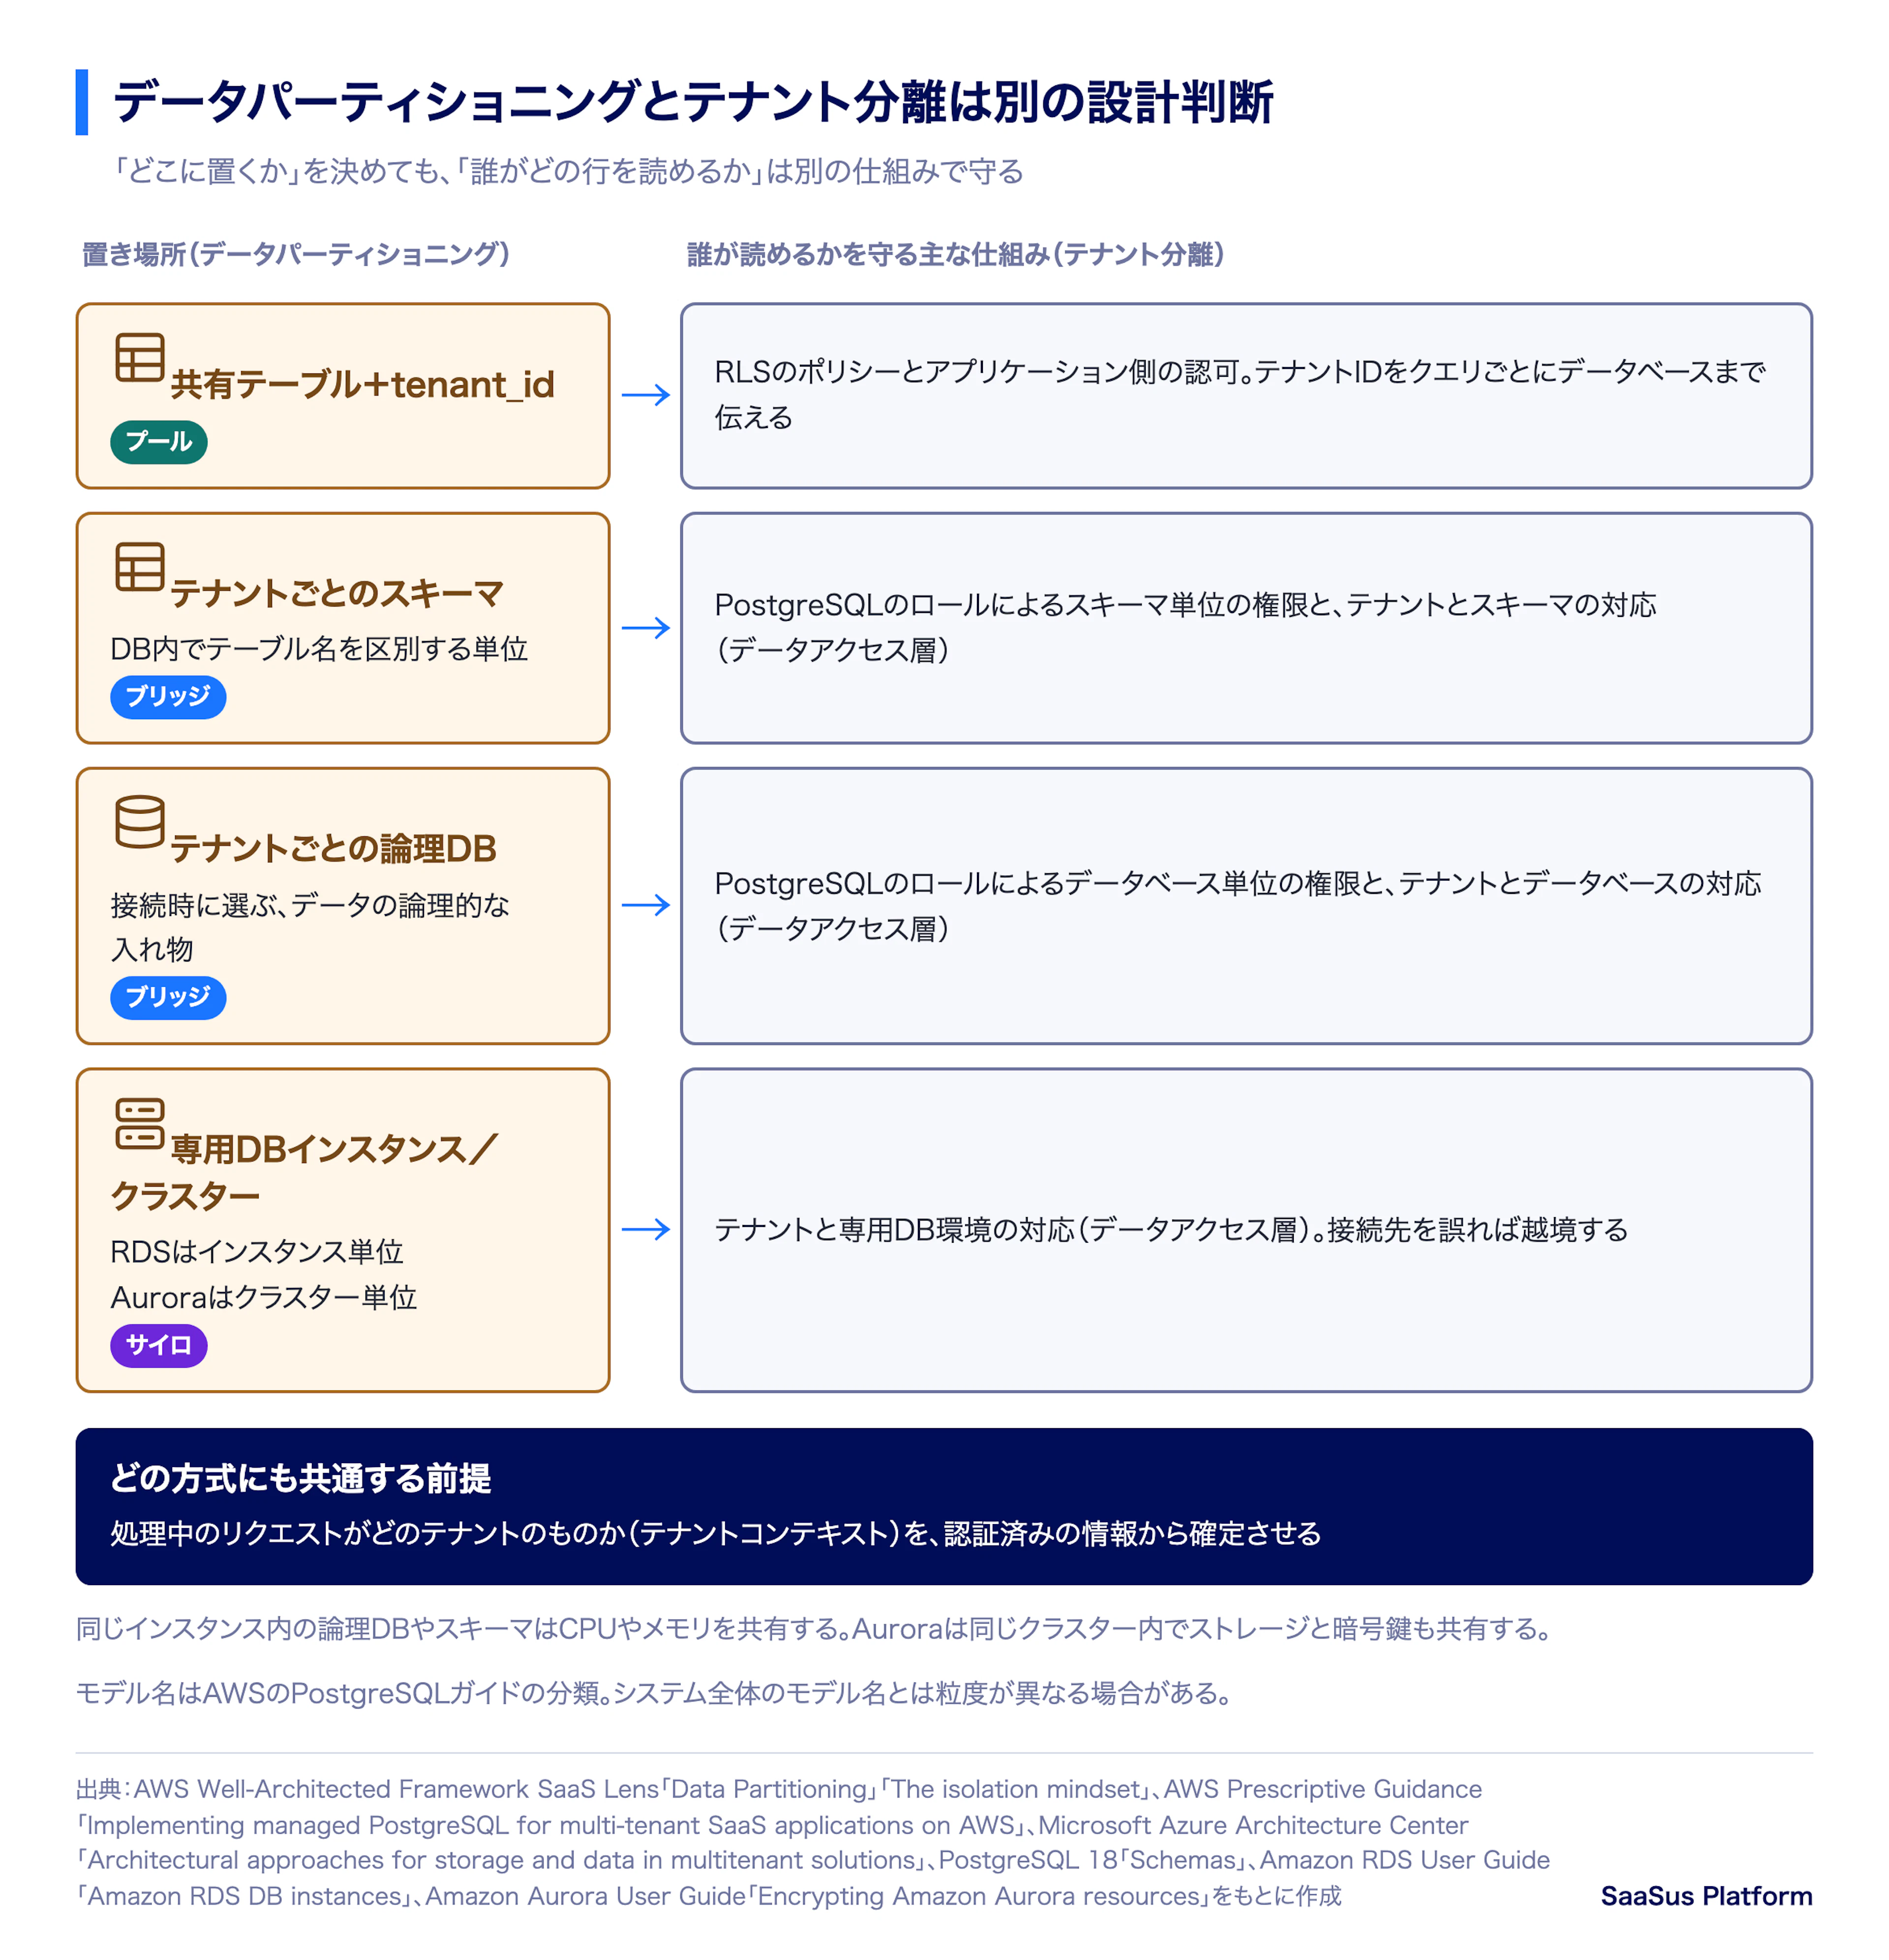
データパーティショニングとは、テナントのデータを別々のデータベースに置くか、共有の構造に混在させるかといった保存の形を決めることです。AWSの設計ガイド「AWS Well-Architected Framework SaaS Lens」(2023年4月公開。以下、SaaS Lens)で使われている用語です。これに対して、あるテナントのリクエストが別のテナントのデータに届かないよう制御する仕組みがテナント分離です。SaaS Lensでは、テナントごとにデータベースなどを分ける形は分離の一般的な形ではあっても唯一の方法ではないとし、「isolation should not be equated to having siloed resources」(分離をサイロ化したリソースと同一視すべきではない)と説明しています。AWSが2022年に公開したホワイトペーパー「SaaS Architecture Fundamentals」でも、この区別を「Partitioning data does not ensure that the data is isolated.」(データを分割してもデータが分離されるとは限らない)と説明しています。このホワイトペーパーはAWSが過去の参照用と表示している資料なので、この区別以外の記述を参考にするときは、SaaS Lensなどの現行の資料と照らし合わせてください。
たとえばテナントごとにデータベースを分けていても、アプリケーションが接続先をリクエストの値から選んでいれば、値を書き換えるだけで別テナントのデータベースに接続できてしまいます。逆に全テナントが同じテーブルを共有していても、テナントコンテキスト(処理中のリクエストがどのテナントのものかを示す情報)に基づいて読み書きできる行を絞れば、テナント分離は成り立ちます。SaaS Lensも、共有リソースでは実行時に適用するポリシーによる論理的な分離がありうると説明しています。
パーティショニングと分離を混同したときの落とし穴は「SaaS開発の落とし穴 〜テナント分離編〜」、コンピュートやネットワークを含むデプロイモデルの比較は「マルチテナントアーキテクチャ設計:プール、サイロ、ブリッジを比較」にまとめています。
置き場所を比べる前に、DBインスタンス、論理DB、スキーマと、AuroraのDBクラスターを区別しておきます。
- DBインスタンス:PostgreSQLを動かす実行環境で、CPUやメモリなどの資源を持ちます。Amazon RDSのDBインスタンスの説明によると、一つのインスタンスに複数のデータベースを作れます。
- 論理データベース(論理DB):その実行環境の中に作る、データをまとめる論理的な入れ物です。PostgreSQLでは接続するときに利用するデータベースを指定します。同じインスタンス内の論理DBはCPUやメモリを共有します。
- スキーマ:一つのデータベースの中で、テーブルなどをまとめ、名前を区別するための名前空間です。例えば tenant_a.invoices の tenant_a がスキーマ名、invoices がテーブル名に当たります。PostgreSQLのスキーマの説明は、データベースが複数のスキーマを持ち、スキーマがテーブルなどを含む構造を示しています。
- AuroraのDBクラスター:一つ以上のDBインスタンスと、それらが使うストレージをまとめた単位です。Auroraのクラスターの説明では、インスタンスが一つでもクラスターに当たるとしています。Auroraの暗号化の説明によると、同じクラスター内の各インスタンスは、同じストレージと同じAWS KMSキーを共有します。インスタンスを追加するだけでは、テナント別の保存領域や暗号鍵にはなりません。
論理DBやスキーマを分けることと、CPUやメモリを分けることは別です。また、これらの置き場所を分けても、他テナントへのアクセスを禁止する権限の設計は別に必要です。
3つの配置方式とプール、サイロ、ブリッジの対応
AWS Prescriptive Guidance「Implementing managed PostgreSQL for multi-tenant SaaS applications on AWS」(2021年9月初版、2024年4月29日更新。以下、PostgreSQLガイド)では、PostgreSQLでのデータパーティショニングをサイロ、ブリッジ、プールの3モデルで整理しています。サイロはテナントごとに専用のリソースを用意する形、プールは全テナントでリソースを共有する形で、ブリッジは両者を組み合わせる形です。ただし、配置方式とモデルは1対1では対応しません。データベースを分ける方式は、何を専用にするかによってブリッジとサイロの両方にまたがります。
共有テーブルにtenant_idを持たせる方式(プール)
全テナントの行を同じテーブルに格納し、各行のtenant_id列でどのテナントのものかを区別する方式です。PostgreSQLガイドのプールモデルの説明では、テナント追加に新しいインフラが要らないためオンボーディング(新しいテナントを使える状態にするまでの処理)を自動化しやすい一方、あるテナントの負荷がほかのテナントの性能に影響するノイジーネイバーは完全には取り除けないとされています。
テナントごとにスキーマを分ける方式(PostgreSQLガイドの分類ではブリッジ)
1つのデータベースの中にテナントごとのスキーマを作り、同じ構造のテーブルをそれぞれに置く方式です。PostgreSQLガイドはこれをブリッジの1形態とし、アプリケーションかデータアクセス層が「テナントとスキーマの対応」を持つ必要があると書いています。テナント数とテーブル数に応じてPostgreSQLのシステムカタログが大きくなる点も、PostgreSQLガイドの比較表に挙がっています。
テナントごとにデータベースやDB環境を分ける方式(PostgreSQLガイドの分類ではブリッジまたはサイロ)
この方式には2つの形があります。同じDBインスタンスやクラスターの中にテナントごとの論理データベースを作る形を、PostgreSQLガイドはブリッジに分類しています。論理DBを分けてもCPUやメモリなどの資源を共有するため、ノイジーネイバーの懸念は残ります。一方、テナントごとに専用のDBインスタンスまたはクラスターを用意する形がサイロです。RDS for PostgreSQLではDBインスタンスを、Aurora PostgreSQLではDBクラスターをテナントごとに分けます。専用のDB環境にすれば、テナントごとに性能を調整でき、障害の影響を1テナントに閉じ込めやすくなります。
方式を比較する観点
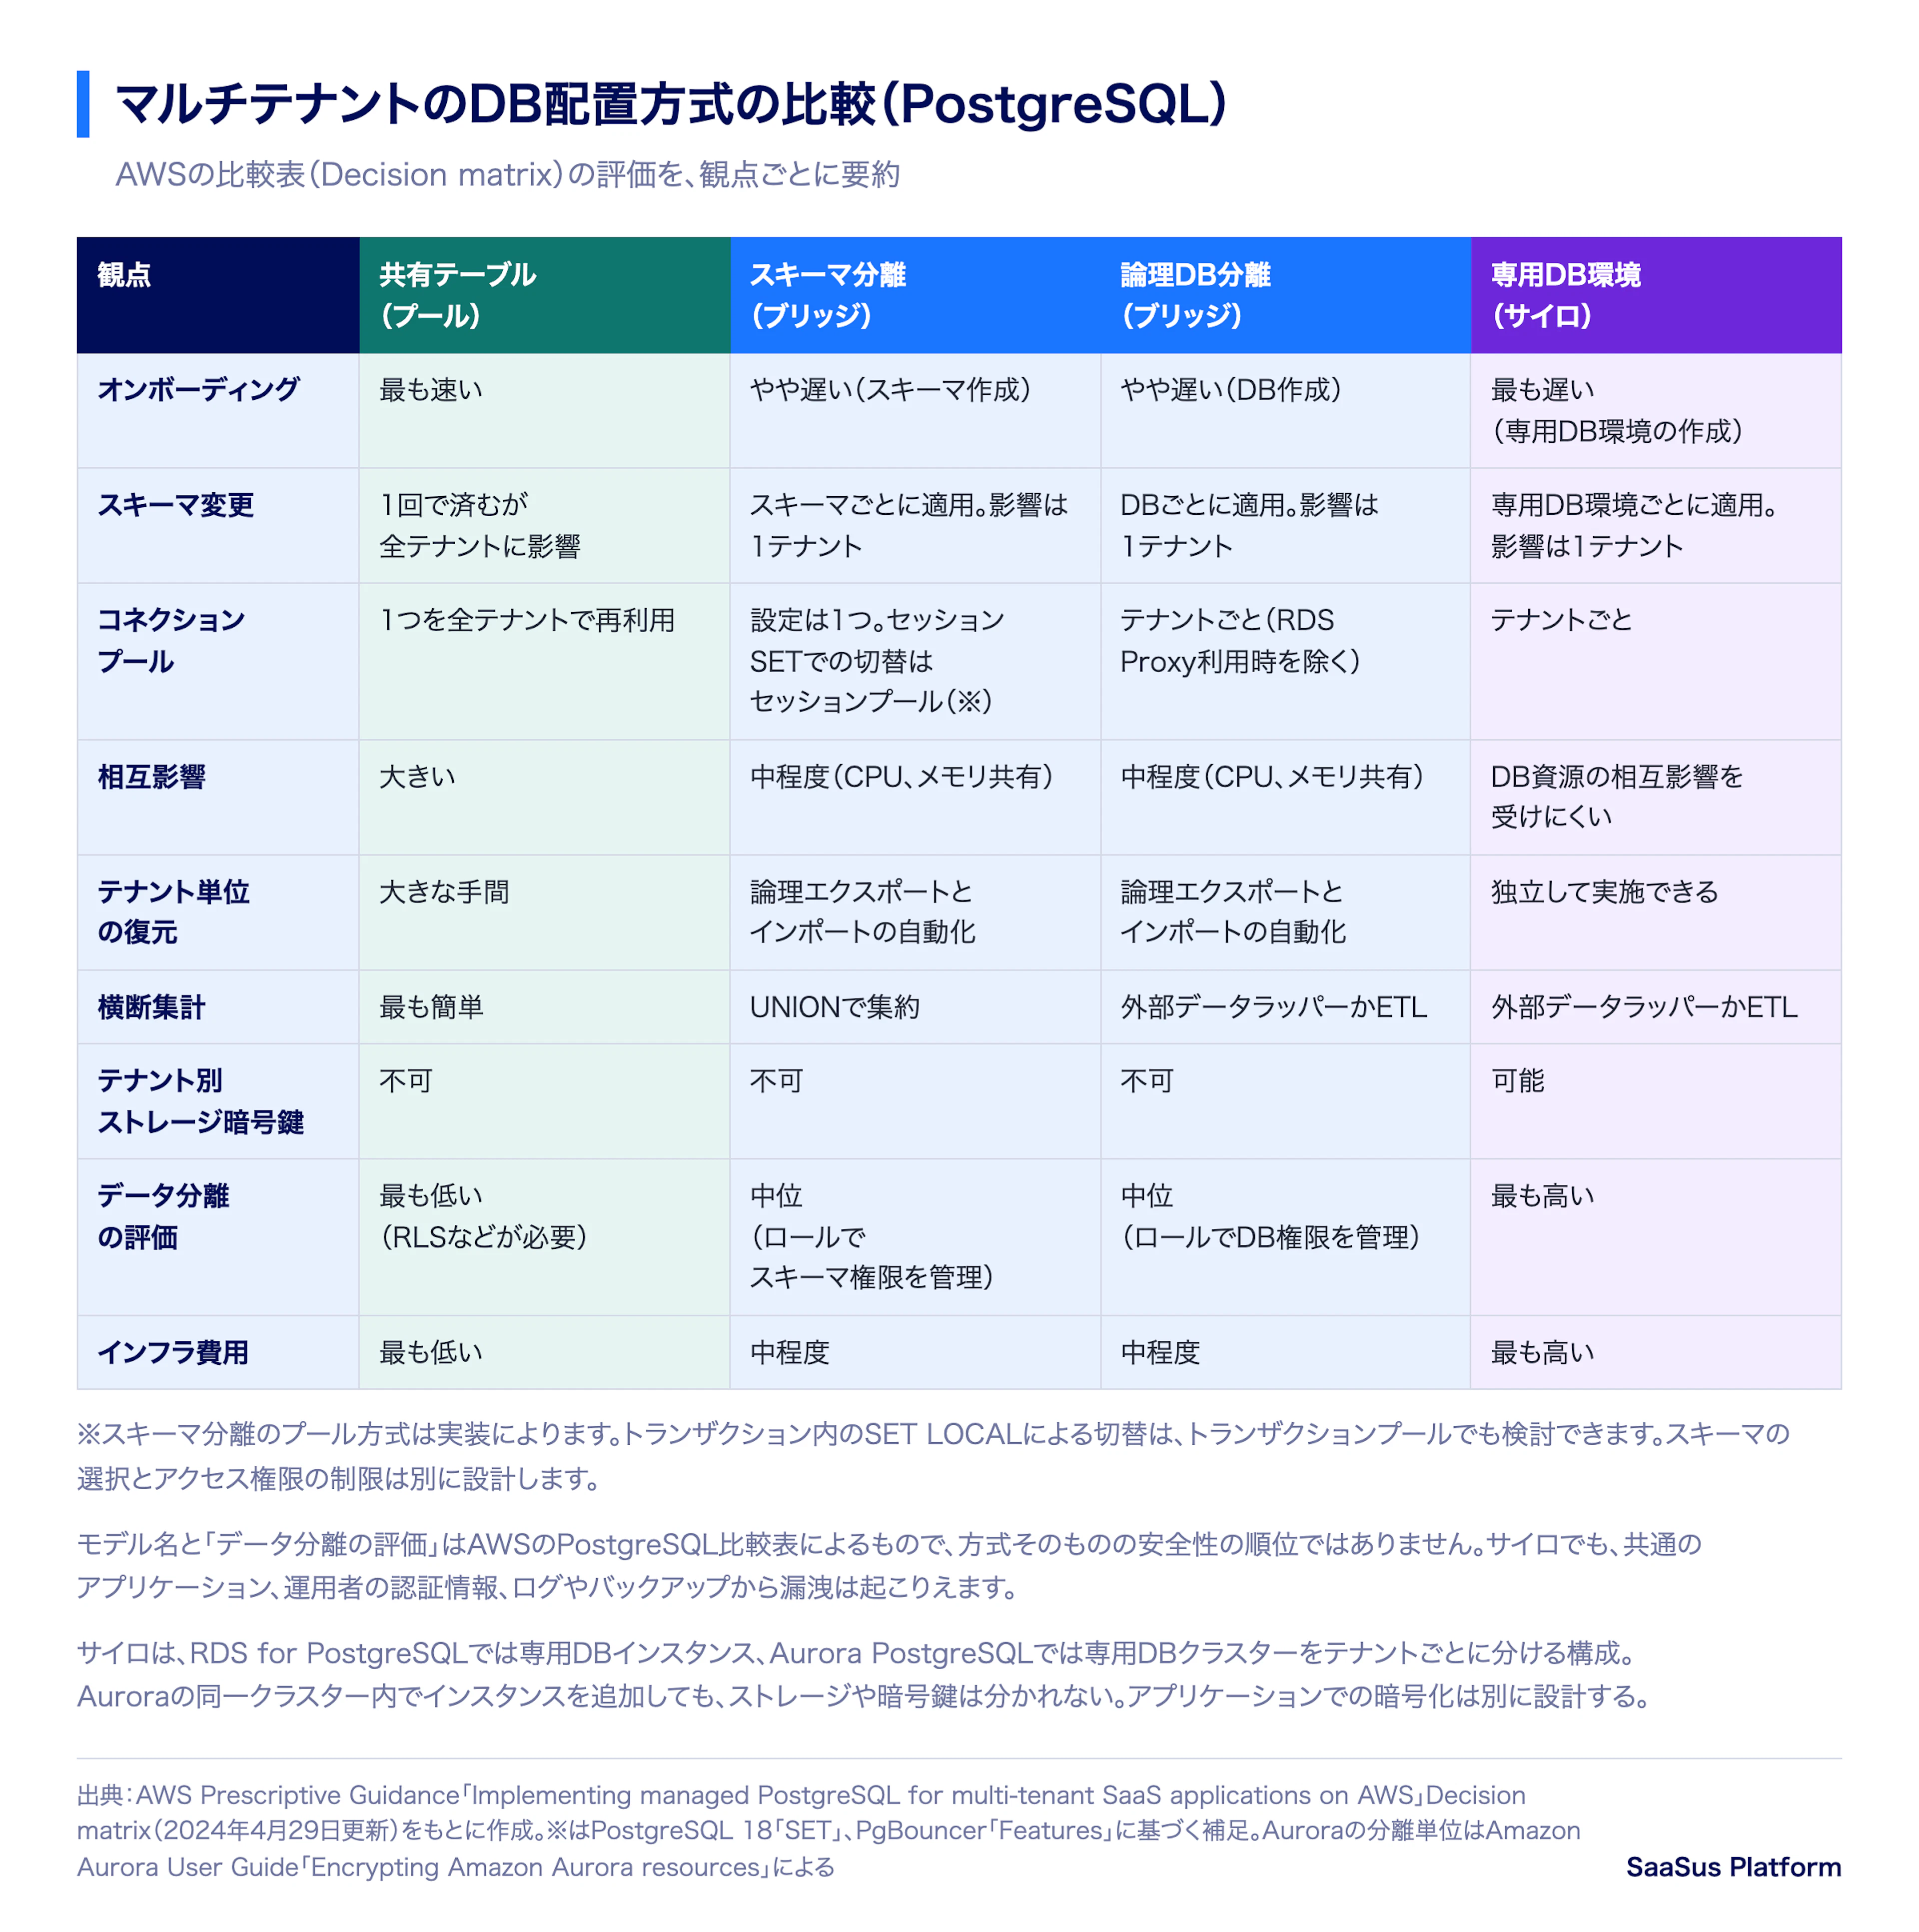
PostgreSQLガイドには、方式ごとの評価をまとめた比較表(Decision matrix)があります。評価は観点ごとに分かれ、すべての観点で優位に立つ方式はありません。ここでは、設計判断に関わる次の観点で評価を整理します。
- オンボーディング:共有テーブルが最も速く、スキーマや論理データベースは作成が要る分だけ遅く、専用のDBインスタンスやクラスターを作るサイロが最も遅くなります。
- スキーマ変更の適用:共有テーブルは1回で済む代わりに全テナントに影響します。分ける方式では影響が1テナントに限られる一方、分けた単位ごとに適用が必要です。
- コネクションプール:共有テーブルは1つのプールを全テナントで再利用できます。スキーマ分離もプールの設定を1つにできます。AWS比較表が示す、セッション単位のSET ROLEやSET SCHEMAで切り替える方式では、接続の再利用にセッションプールを使います。論理データベースや専用のDBインスタンス・クラスターを分けると、テナントごとにプールが要ります(論理データベースはAmazon RDS Proxyを使う場合を除く)。
- 性能と相互影響:共有テーブルはテーブルの肥大に伴いクエリ性能の維持に手間がかかり、テーブルパーティショニングやシャーディングで対処します。Amazon Auroraには、シャーディングをサービス側で管理するAurora PostgreSQL Limitless Databaseもあります。シャードキーに指定した列の値が同じ行を同じシャードに置き、アプリケーションからは1つのデータベースとして接続できる構成です。RLSなど本記事で扱う機能がこの構成で同じように使えるかは、採用時にドキュメントで確認してください。スキーマや論理データベースの分離はCPUとメモリを共有するため影響が残り、サイロではデータベースの資源についてテナント間の影響を受けにくくなります。
- テナント単位の復元:サイロは各テナントを独立して扱え、スキーマや論理データベースの分離は論理エクスポートとインポートの自動化が必要で、共有テーブルは大きな手間がかかります。
- テナント横断の集計:共有テーブルが最も簡単で、スキーマ分離はUNIONで集約でき、論理データベースや専用のDBインスタンス・クラスターを分けると外部データラッパーかETLが必要です。
- 暗号鍵と費用:この比較表の4方式では、テナント別のAWS KMSキーでストレージを暗号化できるのは、DBインスタンスやクラスターをテナントごとに分けるサイロです。Auroraでは、同じクラスター内でインスタンスを分けるだけでは暗号鍵は分かれません。インフラ費用はサイロが最も高く、共有テーブルが最も低くなります。
- データ分離:比較表はサイロを最も高く評価し、スキーマ分離と論理データベース分離はPostgreSQLのロールで権限を管理できるとして中位、共有テーブルはRLSなどの実装が必要だとして最も低く評価しています。これはAWSの比較表による評価で、方式そのものの安全性の順位ではありません。
スキーマ分離そのものが、トランザクション単位の接続プールを使えないという意味ではありません。PostgreSQLのSET LOCALは設定を現在のトランザクション内に限定し、PgBouncerのトランザクションプールはその間、同じサーバー接続を割り当てます。各トランザクションの先頭でSET LOCAL search_pathを設定し、後続のクエリを同じトランザクション内で実行する設計も検討できます。ただし、アプリケーションやORMがトランザクションをまたぐセッション状態に依存しないことを確認します。
search_pathはテーブル名を解決するスキーマを選ぶ設定であり、それだけで他テナントへのアクセスを禁止するものではありません。スキーマやテーブルへの操作権限は、ロールへの権限付与で別に管理します。
比較表にない観点として、契約終了時のデータ削除があります。テナントごとにパーティションを分けていない共有テーブルでは、テナントの削除はtenant_idを条件にした行の削除になります。PostgreSQLの公式ドキュメント(PostgreSQL 18)の「Routine Vacuuming」によると、DELETEは古い行をすぐには取り除かず、その領域を再利用できるようにするにはVACUUMが必要で、通常のVACUUMは原則として領域をOSに返しません。データ量の多いテナントを削除すると、削除の処理と、その後の領域の整理が、同じテーブルを使うほかのテナントにも負荷として及ぶことがあります。スキーマや論理データベースを分けていれば、保持が必要な記録を別に退避したうえで、スキーマやデータベースごと削除できます。専用のDB環境を分けている場合は、RDS for PostgreSQLではDBインスタンス、Aurora PostgreSQLではDBクラスターを削除の単位として扱います。消した範囲も、分けた単位で説明できます。どの方式でも、バックアップ、検索インデックス、分析基盤、ログといった複製先に残るデータは別に洗い出し、それぞれがいつ消えるかを決めておく必要があります。
この評価は「サイロにすれば越境は起きない」という意味ではありません。サイロでも、共通のアプリケーションの脆弱性、運用者の認証情報、共通のログやバックアップから漏洩は起こりえます。この点は「マルチテナントSaaSは危険なのか?データ漏洩について考える」で原因ごとに整理しています。
PostgreSQLのRLSで共有テーブルに境界を置く
共有テーブルをアプリケーションのクエリだけで分離する場合は、すべてのクエリにtenant_idの条件が付くことが前提になります。条件を書き忘れたクエリが1つでもあれば、そのクエリは全テナントの行を対象にします。PostgreSQLの行レベルセキュリティ(RLS)とは、テーブルに定義したポリシーで、クエリが返す行と変更できる行をデータベース側で制限する機能です。PostgreSQLガイドでは、RLSに関する推奨で、テナントごとにPostgreSQLのユーザーを作る方法よりも、アプリケーションが実行時に設定する変数とtenant_id列を比べる方法を推奨し、テナントのデータを持つすべてのテーブルでRLSを有効にすることをベストプラクティスとしています。
次の例では、テーブル所有者のロールでテーブルを作ってRLSを有効にし、ポリシーを定義します。アプリケーションは、スーパーユーザーでもBYPASSRLS属性付きでもない別のロール(app_user)で接続する想定です。
-- テーブル所有者のロールで実行
CREATE TABLE invoices (
  id        bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  tenant_id text    NOT NULL CHECK (tenant_id <> ''),
  amount    integer NOT NULL
);

ALTER TABLE invoices ENABLE ROW LEVEL SECURITY;

CREATE POLICY tenant_isolation ON invoices
  USING      (tenant_id = NULLIF(current_setting('app.tenant_id', true), ''))
  WITH CHECK (tenant_id = NULLIF(current_setting('app.tenant_id', true), ''));

GRANT SELECT, INSERT, UPDATE, DELETE ON invoices TO app_user;
USING句の条件は、クエリから見える行を決めます。WITH CHECK句の条件は、INSERTやUPDATEで書き込まれる行に適用され、条件を満たさない行があるとエラーになります。current_settingの第2引数をtrueにすると、変数が未設定のときはNULLが返りますが、同じ接続で一度set_config(..., true)を使った後は空文字が返ります。そこで、NULLIFで空文字もNULLに変換し、どちらの場合もポリシー条件が真にならないようにします。テーブル側にもCHECK制約を付け、空文字のtenant_idを保存できないようにしています。
アプリケーションは、トランザクションの最初にテナントIDを設定してからクエリを実行します。set_configの第3引数をtrueにすると、設定はそのトランザクションの間だけ有効になります。
-- app_user で実行(tenant_a の行が2件、tenant_b の行が1件ある状態)
BEGIN;
SELECT set_config('app.tenant_id', 'tenant_a', true);

SELECT * FROM invoices;
-- tenant_a の2行だけが返る

SELECT * FROM invoices WHERE tenant_id = 'tenant_b';
-- 0行(WHERE句で指定しても返らない)

INSERT INTO invoices (tenant_id, amount) VALUES ('tenant_b', 999);
-- ERROR:  new row violates row-level security policy for table "invoices"
ROLLBACK;
この2つの例のポリシーと操作はPostgreSQL 18.6で確認しました。tenant_aの行だけを取得でき、tenant_bへのINSERTは拒否され、UPDATEとDELETEはどちらも0件でした。テナントIDが未設定・空文字の場合と、トランザクション終了後に空文字へ戻った場合のSELECTは0行で、書き込みも拒否されました。
RLSで見落としやすい点
上の例の結果は、所有者と分けたapp_userで、トランザクションごとにテナントIDを設定した場合のものです。RLSを使う際は、この適用条件を保つ必要があります。条件が1つ変わると結果も変わるため、次の4点を確認します。
1つ目は、RLSが適用されないロールがあることです。PostgreSQLのドキュメントの「Row Security Policies」によると、スーパーユーザーとBYPASSRLS属性を持つロールは常にRLSをバイパスし、テーブル所有者も通常はバイパスします。所有者にも適用するにはALTER TABLE ... FORCE ROW LEVEL SECURITYを設定します(検証では、テナントID未設定の所有者から見える件数がFORCEの設定前3件、設定後0件でした)。アプリケーションの接続ロールは所有者と分け、NOSUPERUSERかつNOBYPASSRLSにしておく必要があります。
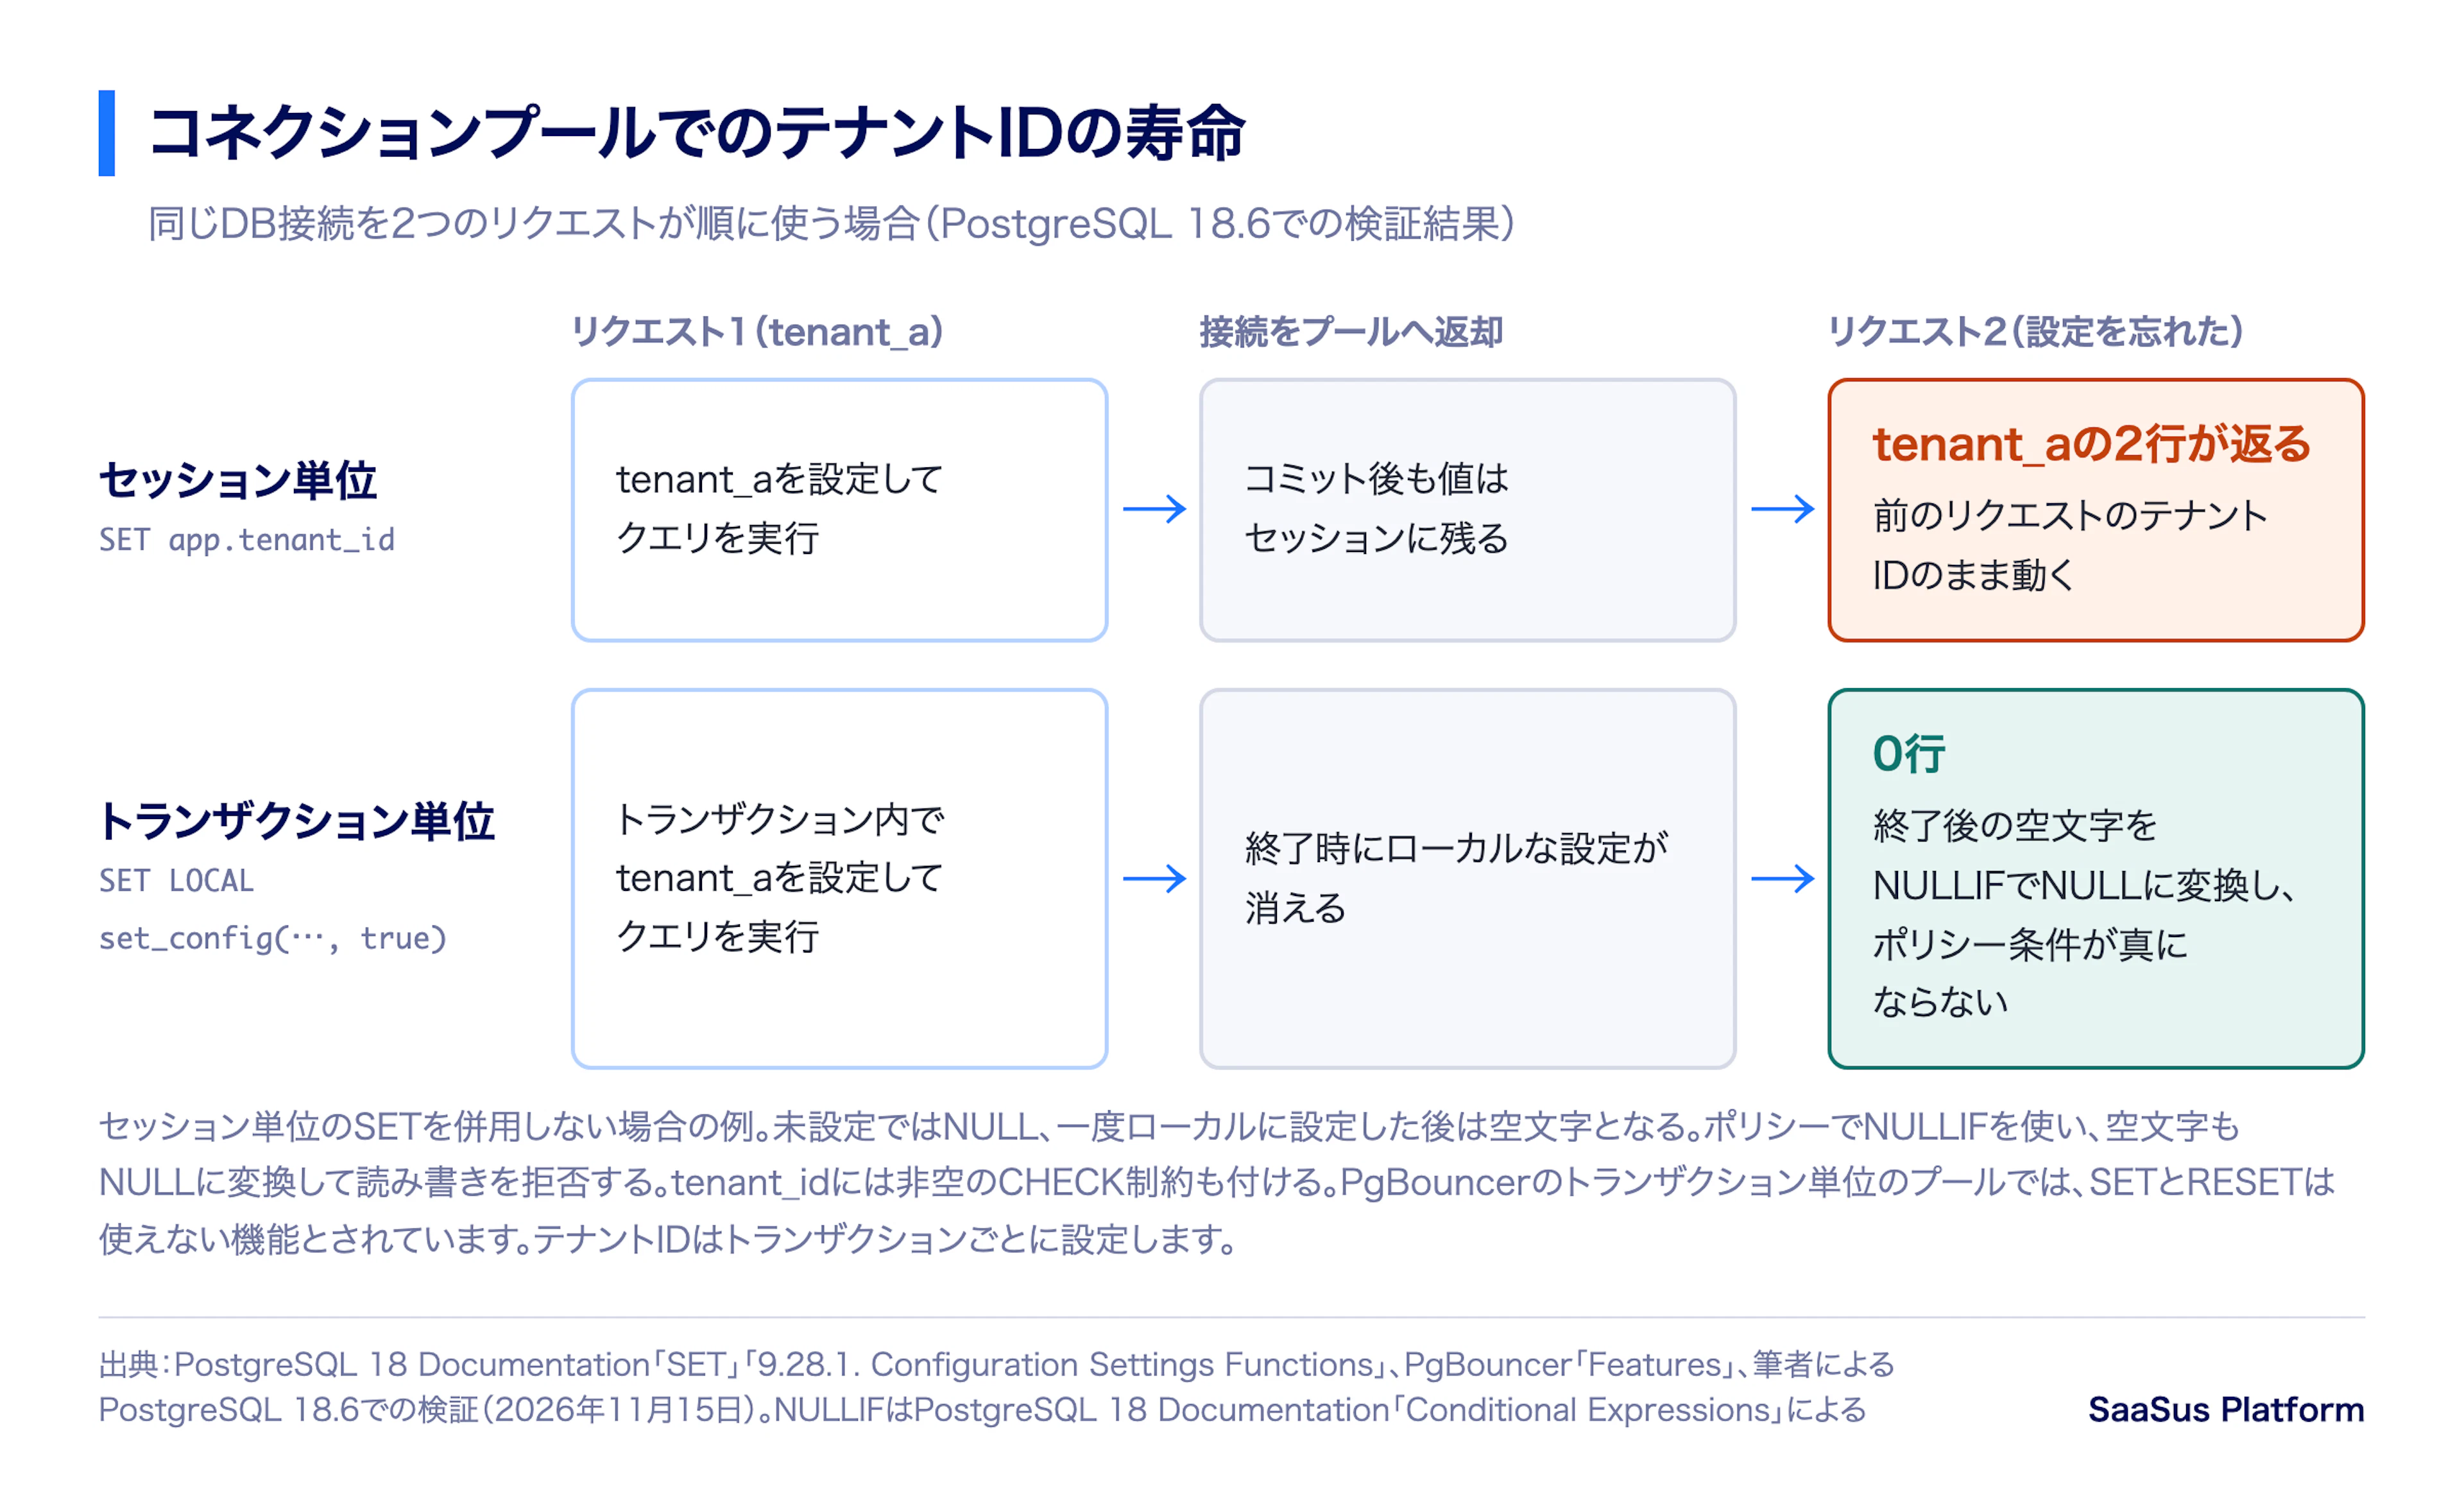
2つ目は、コネクションプールとセッション変数の関係です。PostgreSQLのSETの値はコミット後もセッションが終わるまで残り、SET LOCALとset_config(..., true)の値はトランザクションの終了で消えます。検証でも、セッション単位でtenant_aを設定したまま次のクエリを流すと、設定し直していないのにtenant_aの2行が返りました。プールがこの接続を別のリクエストに渡し、そのリクエストがテナントIDを設定し直さなければ、前のテナントIDのまま別テナントのクエリが動きます。コネクションプーラーのPgBouncerも、ドキュメントの「Features」で、トランザクション単位のプールで使えない機能にSETとRESETを挙げています。テナントIDはトランザクションごとに設定し、終了とともに消える形にします。
3つ目は、マイグレーションとバッチ処理です。所有者のロールでマイグレーションを実行すると、FORCEを設定していなければ全テナントの行が見え、設定していればテナントIDを設定しない限り行が見えません。pg_dumpは既定でrow_securityをoffにして全行を出力しようとし、RLSをバイパスできないユーザーではエラーになります。テナントをまたぐバッチをBYPASSRLS付きのロールで動かすと全テナントの行が見える(検証でも全3件が返りました)ため、こうしたロールは用途ごとに分け、アプリケーションの接続には使いません。主キー、一意制約、外部キーの検査は常にRLSをバイパスするとドキュメントにあり、制約違反のエラーから他テナントのデータの存在を推測できないかも設計時に確認します。
4つ目は、RLSがアプリケーション側の認可を置き換えないことです。MicrosoftのAzure Architecture Centerの解説「Architectural approaches for storage and data in multitenant solutions」は、RLSではユーザーとテナントの識別情報をクエリごとにデータストアまで伝える必要があり、設計からテスト、保守までが複雑になると説明しています。ポリシーが参照するテナントIDが誤っていれば、RLSはその誤った値のとおりに行を返します。テナントIDを認証済みのトークンなどから確定させる方法は「SaaSの認証と認可の設計:テナントIDとユーザー権限を安全に扱う」で扱います。
方式を選ぶための判断基準
方式は、次の問いに答えていくと絞り込めます。
- 契約や規制で、テナント別の暗号鍵や独立したDB環境を求められるか。Amazon RDSやAuroraのストレージ暗号化の単位でテナント別の鍵が必要な場合や、DB環境そのものの独立を求められる場合は、サイロが候補になります。どの単位まで分かれている必要があるかは、暗号鍵、バックアップ、性能、障害の影響範囲のそれぞれについて確認します。
- テナント数とテナントあたりのデータ量はどの程度か。PostgreSQLガイドの比較表は、多数のテナントが少量ずつデータを持つ場合にプール、中程度のテナント数とデータ量でテナント横断の参照が必要な場合にスキーマ分離のブリッジ、大規模で性能要件の厳しいテナントや資源の完全な制御が必要な場合にサイロを挙げています。ただし、テナント数だけで方式は決まりません。同時に利用するテナントの割合や、多数のデータベースを自動で運用できるかどうかも合わせて見ます。
- テナント単位の復元、エクスポート、横断集計をどの程度求められるか。前節のとおり、復元は分けるほど容易になり、横断集計は分けるほど手間が増えます。
- 多数のスキーマやデータベースに、スキーマ変更、監視、バックアップを自動で適用できるか。Azure Architecture Centerは、データベースが増える構成ではスキーマ変更を自動化したパイプラインで展開するよう勧めています。
- 契約終了後、定めた期間内にテナントのデータを削除すると約束しているか。約束しているなら、その期間内に削除を終えられる方式かどうかを確かめます。共有テーブルでは、データ量の多いテナントほど削除に時間がかかります。
1つの方式に全テナントをそろえる必要はありません。通常のプランのテナントは共有テーブルに置き、要件の厳しいテナントだけ専用のデータベースに置くといったティア別の組み合わせも取れます。この組み合わせ方は「SaaS開発の落とし穴 〜データパーティショニング編〜」で、データベース以外のストレージの分け方は「ストレージのテナント分離 ~S3バケット単位のサイロ化を試してみた~」で紹介しています。
後から方式を変えるときに備えること
PostgreSQLガイドの比較表では、共有テーブルから性能に敏感な特定テナントを切り出す作業は、全テナントが同じテーブルを共有しているために大きな手間がかかり、多くの場合アプリケーションロジックの変更も伴うとされています。スキーマや論理データベースを分けている場合も、論理レプリケーションかpg_dumpでデータを移すことになり、データ量によっては停止時間が長くなります。
そのため、最初の方式とは別に、移行に備えた設計を用意しておくことを勧めます。1つは、テナントと接続先(データベース、スキーマ、インスタンス)の対応を1か所に持ち、データアクセス層が必ずそこから接続先を解決するようにすることです。対応そのものは、アプリケーションのコードに埋め込まず、テナント管理の仕組みや設定ストアに置くと、運用の側から変更できます。PostgreSQLガイドもサイロとブリッジではこの対応をアプリケーションかデータアクセス層が持つ必要があるとしています。同じスキーマとアクセス方式を保ち、接続先の違いをデータアクセス層で扱える場合は、対応の更新で接続先を切り替えられます。共有テーブルからスキーマ分離へ移すなど方式自体を変える場合は、SQL、権限、RLS設定などの変更も別に確認します。データの移し替えと切り替えの手順は別に必要です。もう1つは、スキーマやデータベースを分ける方式でもテーブルにtenant_id列を残すことです。行の持ち主がデータ自体に残っていれば、共有テーブルへの統合も共有テーブルからの抽出も同じ条件で行えます。
当社が提供するSaaS開発基盤 SaaSus Platformを使う場合、ログインしたユーザーが所属するテナントのIDはSaaSus SDKで取得できます。SaaSus Platformのチュートリアルのうち、Expressのアプリケーションに認証を組み込む手順は、取得したテナントIDをtenant_id列の検索条件と保存値に使う共有テーブルの例を示し、スキーマ分離やデータベース分離でも同様にSDKでテナント情報を取得して実装できると説明しています。クエリの条件、RLSのポリシー、接続先の切り替えといったデータ層での分離は、アプリケーション側で実装します。
どの置き方を選んでも、tenant_idの値が誤っていれば、RLSも接続先の切り替えもその値のとおりに働きます。方式を決めたあとで最初に確かめたいのは、テナントIDを認証済みの情報から取り出し、クエリの条件、接続先、RLSの変数へ渡すまでの流れです。
SaaSus Platformでテナント情報を取得し、アプリケーションのデータをテナントごとに分ける流れは、SaaSus Platformのチュートリアルで手を動かして確認できます。
SaaS開発の資料をダウンロード
SaaSの開発・設計を検討する際は、以下の資料もご活用ください。各リンク先からダウンロードできます。
- SaaS開発ガイド【基礎編】をダウンロード
- SaaS開発ガイド【テナント編】をダウンロード
- エンタープライズSaaS開発ガイドをダウンロード
- マルチテナントAIエージェント開発ガイド【基礎設計編】をダウンロード
出典
- Amazon Web Services「Implementing managed PostgreSQL for multi-tenant SaaS applications on AWS」AWS Prescriptive Guidance、Tabby Ward, Thomas Davis、2021年9月30日初版、2024年4月29日更新(参照日 2026-11-15。英語版は docs.aws.amazon.com で表示できなかったため、同じ内容を掲載するAWS公式の docs.aws.eu を参照)
- Multi-tenant SaaS partitioning models for PostgreSQL:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/partitioning-models.html
- PostgreSQL silo model:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/silo.html
- PostgreSQL pool model:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/pool.html
- PostgreSQL bridge model:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/bridge.html
- Decision matrix:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/matrix.html
- Row-level security recommendations:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/rls.html
- Document history:https://docs.aws.eu/prescriptive-guidance/latest/saas-multitenant-managed-postgresql/doc-history.html
- Amazon Web Services「AWS Well-Architected Framework SaaS Lens」2023年4月4日公開(参照日 2026-11-10)
- Data Partitioning:https://docs.aws.amazon.com/wellarchitected/latest/saas-lens/data-partitioning.html
- The isolation mindset:https://docs.aws.amazon.com/wellarchitected/latest/saas-lens/isolation-mindset.html
- Amazon Web Services「SaaS Architecture Fundamentals」AWS Whitepaper、2022年8月3日公開(AWSは過去の参照用と表示)、Data partitioning:https://docs.aws.amazon.com/whitepapers/latest/saas-architecture-fundamentals/data-partitioning.html (参照日 2026-11-10)
- PostgreSQL Global Development Group「PostgreSQL 18 Documentation」(2026-11-10時点の current は 18.6)(参照日 2026-11-10)
- 5.9. Row Security Policies:https://www.postgresql.org/docs/18/ddl-rowsecurity.html
- CREATE POLICY:https://www.postgresql.org/docs/18/sql-createpolicy.html
- ALTER TABLE:https://www.postgresql.org/docs/18/sql-altertable.html
- CREATE ROLE:https://www.postgresql.org/docs/18/sql-createrole.html
- SET:https://www.postgresql.org/docs/18/sql-set.html
- 9.28.1. Configuration Settings Functions:https://www.postgresql.org/docs/18/functions-admin.html
- pg_dump:https://www.postgresql.org/docs/18/app-pgdump.html
- 24.1. Routine Vacuuming:https://www.postgresql.org/docs/18/routine-vacuuming.html
- PgBouncer「Features」:https://www.pgbouncer.org/features.html (参照日 2026-11-10)
- Microsoft「Architectural approaches for storage and data in multitenant solutions」Azure Architecture Center、2026年8月21日更新:https://learn.microsoft.com/en-us/azure/architecture/guide/multitenant/approaches/storage-data (参照日 2026-11-10)
- 株式会社アンチパターン「Express」(チュートリアル 認証モジュールの組み込み)SaaSus Platform Document:https://docs.saasus.io/ja/docs/tutorial/authentication-module/authentication-express (参照日 2026-11-10)
- 同「はじめに」(チュートリアル):https://docs.saasus.io/ja/docs/tutorial/tutorial-introduction/ (参照日 2026-11-10)
- Amazon Web Services「Aurora PostgreSQL Limitless Database architecture」Amazon Aurora User Guide、https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/limitless-architecture.html (参照日 2026-11-10)
- PostgreSQL 18 Documentation「SET」https://www.postgresql.org/docs/18/sql-set.html 、「Schemas」https://www.postgresql.org/docs/18/ddl-schemas.html 、PgBouncer「Features」https://www.pgbouncer.org/features.html (参照日 2026-11-14)
- Amazon Web Services「Amazon RDS DB instances」Amazon RDS User Guide https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Overview.DBInstance.html 、PostgreSQL Global Development Group「Schemas」PostgreSQL 18 Documentation https://www.postgresql.org/docs/18/ddl-schemas.html (参照日 2026-11-14。DBインスタンス、論理DB、スキーマの用語説明)
- Amazon Web Services「Encrypting Amazon Aurora resources」https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Overview.Encryption.html (参照日 2026-11-15。クラスター内の共有ストレージと暗号鍵)
- Amazon Web Services「Amazon Aurora DB clusters」https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/Aurora.Overview.html (参照日 2026-11-15。一つ以上のDBインスタンスとストレージからなる単位)
- PostgreSQL Global Development Group「CREATE POLICY」「NULLIF」「Constraints」PostgreSQL 18 Documentation https://www.postgresql.org/docs/18/sql-createpolicy.html 、https://www.postgresql.org/docs/18/functions-conditional.html#FUNCTIONS-NULLIF 、https://www.postgresql.org/docs/18/ddl-constraints.html (参照日 2026-11-15。NULL・空文字を拒否するポリシーとCHECK制約)
Spread the word:

